FinOps en Databricks y Snowflake: claves para frenar el sobrecoste de cómputo

Dónde se va el dinero en una plataforma de datos en la nube y qué reglas concretas lo frenan sin frenar al negocio
Respuesta rápida:
El sobrecoste en Databricks y Snowflake casi nunca se debe a que la plataforma sea cara, sino a cómo se usa: cómputo que se queda encendido sin trabajo, recursos más grandes de lo necesario, consultas que leen mucho más de lo que necesitan y procesos que repiten el mismo trabajo cada día.
Se frena con tres palancas: apagar automáticamente lo que no se usa, con la autoterminación de clusters y el AUTO_SUSPEND de los warehouses; poner límites de consumo, con políticas de cluster, resource monitors, presupuestos y tiempos máximos de consulta; y atribuir cada gasto a su equipo mediante etiquetas, para que quien genera el coste lo vea.
FinOps no es un proyecto de ahorro puntual, sino un hábito: medir, optimizar y operar con reglas que se aplican solas.
En una plataforma de datos en la nube no se paga por lo que se usa: se paga por lo que se deja encendido.
La promesa de la nube es pagar solo por lo que se consume. En la práctica, las plataformas de datos modernas facturan por tiempo de cómputo encendido, medido en DBUs en Databricks y en créditos en Snowflake, y ese tiempo se dispara por decisiones pequeñas que nadie revisa: un cluster interactivo que alguien dejó abierto el viernes, un warehouse grande creado para una carga puntual que se quedó para siempre o un dashboard que se refresca cada cinco minutos aunque nadie lo mire de noche.
Cuando llega la factura, el equipo de finanzas pregunta por qué ha crecido, y el equipo de datos no sabe responder con precisión qué equipo, qué proceso o qué consulta la ha hecho crecer.
La factura de cómputo no es un problema técnico ni financiero: es un problema de visibilidad. Nadie optimiza lo que no ve.
Por qué se dispara el coste en las plataformas de datos en la nube
La elasticidad funciona en las dos direcciones. Crear un cluster o un warehouse lleva segundos y no requiere aprobación, así que cualquier equipo puede aumentar el gasto sin darse cuenta. Y como el consumo se reparte entre muchos usuarios, procesos y herramientas, nadie siente como propio el total. El resultado es predecible: el coste crece más deprisa que el valor que genera la plataforma.
Los cinco focos habituales de sobrecoste
- Cómputo encendido sin uso: clusters interactivos que nadie apaga y warehouses con tiempos de suspensión largos que siguen consumiendo entre consulta y consulta.
- Recursos sobredimensionados: un warehouse grande para consultas que caben en uno pequeño, o clusters con un máximo de workers muy por encima de lo que la carga necesita.
- Consultas ineficientes: lecturas completas de tablas por falta de filtros, particionado o clustering,
SELECT *sobre tablas anchas y uniones que multiplican filas. - Procesamiento redundante: recargas completas diarias donde bastaría una carga incremental, varios equipos calculando lo mismo en pipelines distintos y dashboards que se refrescan mucho más de lo necesario.
- Cargas mezcladas: ETL pesado y consultas de BI en el mismo cluster o warehouse, que obligan a dimensionarlo todo para el pico.
Las tres palancas para frenar el gasto
Casi todo el ahorro sostenible sale de tres palancas que existen tanto en Databricks como en Snowflake, aunque con nombres distintos.
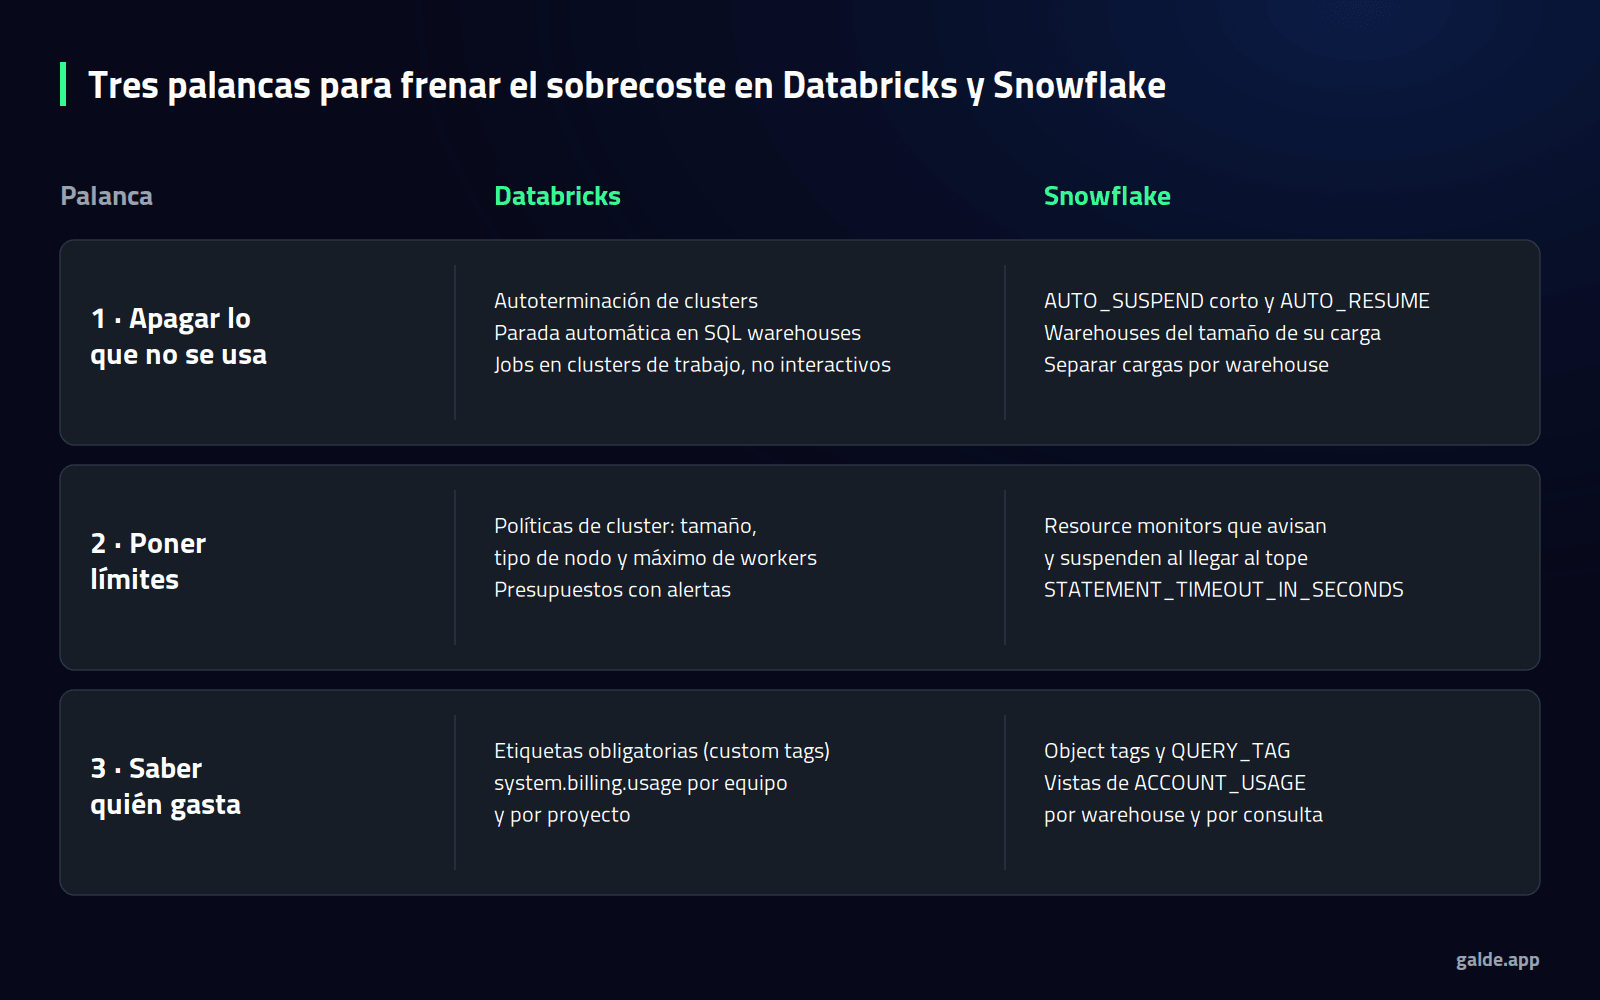
Palanca 1: apagar lo que no se usa
En Databricks
- Autoterminación en todos los clusters interactivos: un cluster sin actividad debe apagarse solo en minutos, no en horas.
- Clusters de trabajo para los procesos programados: los jobs deben ejecutarse en clusters de trabajo, que nacen y mueren con cada ejecución y tienen una tarifa por DBU inferior a la de los clusters de uso general.
- Parada automática en los SQL warehouses, ajustada al patrón real de uso de cada equipo.
En Snowflake
AUTO_SUSPENDcorto yAUTO_RESUMEactivado: el warehouse se suspende al quedarse sin trabajo y se reanuda solo con la siguiente consulta.- Tamaño ajustado a la carga: empezar pequeño y subir solo si las consultas hacen cola o no cumplen su tiempo objetivo.
- Separar cargas por warehouse: uno para ETL y otro para BI, cada uno con su tamaño y su tiempo de suspensión.
ALTER WAREHOUSE bi_wh SET
  AUTO_SUSPEND = 60      -- segundos sin actividad antes de suspender
  AUTO_RESUME = TRUE;
Conviene un matiz: Snowflake factura un mínimo de 60 segundos cada vez que un warehouse arranca, y al suspenderlo se pierde su caché local. En warehouses de BI con consultas frecuentes, suspender demasiado rápido puede costar más de lo que ahorra; el tiempo óptimo depende del patrón de uso de cada carga.
Palanca 2: poner límites de consumo
En Databricks: políticas de cluster y presupuestos
Las políticas de cluster definen qué puede crear cada equipo: tipos de nodo permitidos, tamaño máximo, tiempo de autoterminación y etiquetas obligatorias. Así, el ahorro no depende de que cada usuario configure bien su cluster.
{
  "autotermination_minutes": { "type": "range", "maxValue": 30, "defaultValue": 20 },
  "autoscale.max_workers": { "type": "range", "maxValue": 8 },
  "custom_tags.centro_coste": { "type": "unlimited", "isOptional": false }
}
Con esta política, ningún cluster puede quedarse encendido más de 30 minutos sin actividad ni crecer por encima de 8 workers, y ninguno se crea sin su centro de coste. A nivel de cuenta, los presupuestos envían alertas cuando el gasto de un equipo o proyecto se acerca a lo previsto.
En Snowflake: resource monitors, budgets y tiempos máximos
Los resource monitors fijan una cuota de créditos por periodo y actúan al alcanzarla: avisar, suspender el warehouse cuando terminan las consultas en curso o suspenderlo de inmediato.
CREATE RESOURCE MONITOR rm_analitica WITH
  CREDIT_QUOTA = 500
  FREQUENCY = MONTHLY
  START_TIMESTAMP = IMMEDIATELY
  TRIGGERS ON 80 PERCENT DO NOTIFY
           ON 100 PERCENT DO SUSPEND
           ON 110 PERCENT DO SUSPEND_IMMEDIATE;

ALTER WAREHOUSE bi_wh SET RESOURCE_MONITOR = rm_analitica;
Los resource monitors cubren los warehouses. Para los servicios serverless, Snowflake ofrece budgets con alertas. Y el parámetro STATEMENT_TIMEOUT_IN_SECONDS corta cualquier consulta que supere el tiempo máximo razonable para su warehouse, antes de que una consulta mal escrita consuma créditos durante horas.
Palanca 3: saber quién gasta
Sin atribución, el coste es de todos y, por tanto, de nadie. El objetivo es que cada euro de cómputo tenga un equipo, un proyecto o un producto de datos al que pertenezca.
- En Databricks, las etiquetas de los clusters y warehouses, las
custom_tags, llegan a la tabla de sistemasystem.billing.usage, que permite agregar el consumo por centro de coste, equipo o proyecto. - En Snowflake, las etiquetas de objeto asignan cada warehouse a su equipo, el parámetro
QUERY_TAGidentifica qué proceso o herramienta lanza cada consulta y las vistas deACCOUNT_USAGE, comoWAREHOUSE_METERING_HISTORYoQUERY_ATTRIBUTION_HISTORY, muestran el consumo por warehouse y por consulta.
-- Databricks: consumo del mes por centro de coste
SELECT custom_tags['centro_coste'] AS centro_coste,
       SUM(usage_quantity) AS dbus
FROM system.billing.usage
WHERE usage_date >= date_trunc('MONTH', current_date())
GROUP BY 1
ORDER BY 2 DESC;
Con estos datos, un informe mensual por equipo convierte el coste en una conversación concreta: este proceso cuesta esto, genera este valor y se puede hacer de esta otra forma.
Optimizar las consultas y el procesamiento
Una vez controlado el cómputo encendido, el siguiente ahorro está en el trabajo que se hace:
- Procesamiento incremental: procesar solo lo que ha cambiado desde la última ejecución, con modelos incrementales de dbt, tablas dinámicas en Snowflake o pipelines incrementales en Databricks, en lugar de recalcularlo todo cada noche.
- Organización física de los datos: clustering o particionado alineado con los filtros más frecuentes, para que las consultas lean solo lo necesario. Estas técnicas tienen su propio coste de mantenimiento, así que conviene aplicarlas donde el volumen de consultas lo justifique.
- Revisión periódica de las consultas más caras: un pequeño número de consultas suele concentrar buena parte del consumo; revisarlas cada mes es de las acciones con mejor retorno.
- Frecuencias de refresco realistas: un dashboard que se consulta una vez al día no necesita refrescarse cada cinco minutos.
FinOps como hábito, no como proyecto
El marco de la FinOps Foundation propone tres fases continuas: informar, dando visibilidad del gasto a quien lo genera; optimizar, actuando sobre los focos de sobrecoste; y operar, convirtiendo las buenas prácticas en reglas automáticas y revisiones periódicas.
La clave está en la última. Un ahorro conseguido con un proyecto puntual se pierde en unos meses si no hay políticas que lo sostengan. Por eso conviene medir el coste en unidades de negocio, como el coste por informe, por pipeline o por usuario activo, y revisar esas métricas con los dueños de cada dominio igual que se revisan sus resultados.
¿Tu factura de Databricks o Snowflake crece más deprisa que el valor que obtienes de ella?
En Galde no solo construimos plataformas de datos modernas: las hacemos eficientes. Identificamos dónde se va el cómputo, aplicamos las políticas que lo frenan de forma automática y dejamos a tu equipo con la visibilidad necesaria para que el ahorro se mantenga.
Cómo puede ayudar Galde a controlar el coste de tu plataforma de datos
Desde data platforms, auditamos el consumo de Databricks y Snowflake, rediseñamos la separación de cargas y el dimensionamiento, y aplicamos políticas de cluster, resource monitors y procesamiento incremental donde más impacto tienen. Es la misma visión que aplicamos al elegir entre lakehouse y data warehouse.
Desde gobernanza de datos, convertimos el etiquetado de costes en una política obligatoria, vinculada al dueño de cada producto de datos, para que la atribución no dependa de la buena voluntad de cada equipo.
Y desde la IA generativa, aplicamos la misma disciplina al cómputo que consumen los casos de IA, como la generación de embeddings o la búsqueda vectorial, que tienden a crecer sin control si nadie los mide.
Conclusión
El sobrecoste en Databricks y Snowflake no se resuelve negociando precios, sino cambiando hábitos: apagar lo que no se usa, limitar lo que se puede consumir y atribuir cada gasto a quien lo genera. Con esas tres palancas convertidas en reglas automáticas, la plataforma deja de crecer en coste sin crecer en valor, y la conversación con finanzas pasa de justificar la factura a decidir dónde invertir.
Preguntas frecuentes
¿Qué es FinOps en una plataforma de datos?
Es la práctica de gestionar el coste de la nube de forma continua y compartida entre técnicos, negocio y finanzas: dar visibilidad del gasto a quien lo genera, optimizar los focos de sobrecoste y convertir las buenas prácticas en reglas automáticas.
¿Cuál es la causa más habitual del sobrecoste en Databricks y Snowflake?
El cómputo que se queda encendido sin trabajo: clusters interactivos sin autoterminación y warehouses con tiempos de suspensión largos. Suele ser también la primera palanca, porque se corrige con configuración y sin tocar ningún proceso.
¿Qué tiempo de AUTO_SUSPEND conviene en Snowflake?
Depende de la carga. Para ETL por lotes, un tiempo corto suele ser adecuado. Para BI con consultas frecuentes, suspender demasiado pronto hace perder la caché del warehouse y paga un mínimo de 60 segundos en cada arranque, así que conviene ajustarlo midiendo el patrón real de uso.
¿Los presupuestos detienen el gasto automáticamente?
Depende de la herramienta. En Snowflake, los resource monitors pueden suspender los warehouses al llegar a la cuota. Los presupuestos de Databricks envían alertas, pero no detienen el consumo, así que deben combinarse con políticas de cluster que limiten lo que se puede crear.
¿Por dónde empezar un proyecto de FinOps en datos?
Por la visibilidad: etiquetar clusters y warehouses por equipo y construir un informe mensual de consumo por centro de coste. Con ese mapa, las primeras medidas, como la autoterminación, el tamaño adecuado o la separación de cargas, se priorizan solas.