Cómo evitar que los cambios de software rompan tus pipelines de datos

Contratos de datos, cambios compatibles y pruebas automáticas para que renombrar una columna deje de ser una incidencia
Respuesta rápida:
Los pipelines de datos se rompen con los cambios de software porque suelen depender de la estructura interna de la base de datos transaccional de una aplicación: sus tablas, sus columnas y sus valores. El equipo que mantiene esa aplicación la cambia para mejorar el producto, sin saber que un pipeline de analítica o un dashboard dependen de ella.
La solución combina cuatro prácticas: publicar una interfaz estable en lugar de leer las tablas internas, acordar un contrato de datos entre quien produce el dato y quien lo consume, comprobar ese contrato automáticamente en el CI antes de desplegar cualquier cambio y aplicar los cambios necesarios en fases compatibles: expandir, migrar y contraer.
Así, un cambio incompatible se detecta antes de llegar a producción, cuando todavía es barato corregirlo, y no un lunes por la mañana en un dashboard vacío.
Un dashboard no se rompe cuando alguien renombra una columna. Se rompe porque nadie sabía que ese dashboard dependía de ella.
Es una escena habitual. El viernes, el equipo de producto despliega una mejora en la aplicación de pedidos y, de paso, renombra la columna customer_id a client_id para alinearla con el resto del código. El despliegue es un éxito. El lunes, el dashboard de ventas muestra la mitad de pedidos, el pipeline nocturno ha cargado nulos en la clave de cliente y el equipo de datos pasa la mañana buscando qué ha cambiado.
Nadie ha hecho nada mal. El equipo de producto no tenía forma de saber que alguien leía esa columna, y el equipo de datos no tenía forma de enterarse del cambio antes de sufrirlo.
El problema no es el cambio. Es que el cambio viaja sin aviso desde el equipo que lo hace hasta el equipo que lo sufre.
Por qué los cambios en una aplicación rompen la analítica
La mayoría de las plataformas de datos empiezan copiando las tablas de las bases de datos transaccionales, ya sea con una carga periódica o con captura de cambios (CDC). Es la forma más rápida de tener datos disponibles, pero crea un acoplamiento que nadie ha acordado: el esquema interno de la aplicación, pensado para servir al producto, se convierte sin quererlo en la interfaz de la que dependen informes, modelos y cuadros de mando.
Los cambios que rompen ese acoplamiento no son solo los evidentes:
- Cambios de estructura: renombrar o eliminar una columna, dividir una tabla en dos o cambiar un tipo de dato.
- Cambios de significado: un importe que pasa de incluir impuestos a no incluirlos, o una fecha que cambia de zona horaria.
- Valores nuevos: un estado nuevo en un campo de estados, como
PARCIALMENTE_ENVIADO, que ningún filtro de la analítica contempla. - Cambios de granularidad: una tabla que pasa de una fila por pedido a una fila por línea de pedido.
Los cambios de estructura suelen romper con ruido: el pipeline falla y alguien se entera. Los peores son los de significado y los valores nuevos, porque rompen en silencio: el pipeline termina bien, las cifras cambian y nadie lo detecta hasta que un responsable de negocio desconfía de un informe.
Qué es un contrato de datos y qué debe incluir
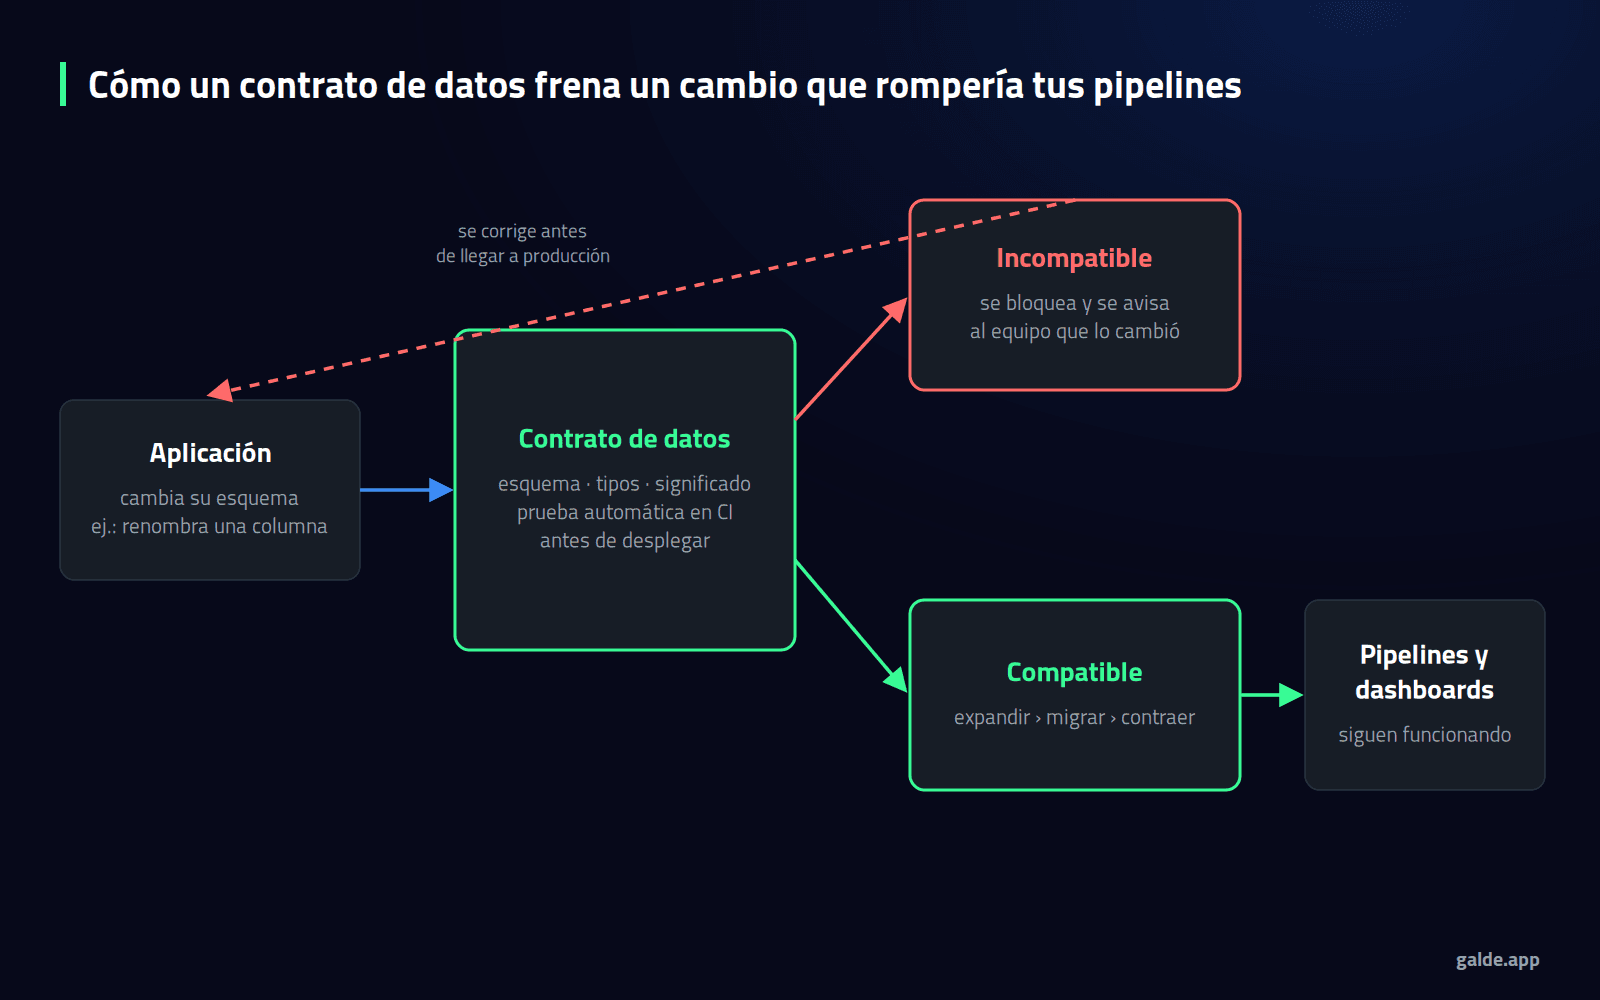
Un contrato de datos es un acuerdo explícito y versionado entre el equipo que produce un dato y los equipos que lo consumen. Describe qué se publica y qué garantías tiene, de forma que cualquier cambio se pueda comparar automáticamente con lo acordado. Un buen contrato recoge:
- Esquema y tipos: qué campos existen, de qué tipo son y cuáles son obligatorios.
- Significado: unidades, zonas horarias, valores permitidos y cómo interpretar cada campo.
- Garantías de calidad: unicidad de claves, ausencia de nulos donde no deben existir, rangos válidos.
- Frescura: cada cuánto se actualiza el dato y con qué retraso máximo.
- Dueño y canal de avisos: quién responde del dato y dónde se comunican los cambios.
- Versión y política de cambios: qué se considera un cambio incompatible y con cuánta antelación se anuncia.
El contrato vive como código, junto al del productor, en un formato legible como YAML. Hay estándares abiertos, como el Open Data Contract Standard, y herramientas que ya lo aplican en partes concretas del flujo: los contratos de modelos de dbt impiden publicar un modelo cuyas columnas o tipos no coinciden con lo declarado, y los registros de esquemas de los sistemas de eventos rechazan un esquema nuevo que no sea compatible con el anterior.
Cómo aplicar contratos de datos sin frenar a los equipos de producto
El objetivo no es que el equipo de producto pida permiso para cada cambio. Es que los cambios compatibles fluyan sin fricción y los incompatibles se detecten solos, a tiempo.
1. Deja de leer las tablas internas: publica una interfaz
El primer paso es separar lo que la aplicación usa por dentro de lo que ofrece hacia fuera. En lugar de copiar sus tablas internas, la aplicación publica una interfaz de datos estable: una vista dedicada, una tabla de salida o eventos de dominio emitidos con el patrón outbox. El equipo puede reorganizar su esquema interno con libertad mientras mantenga esa interfaz.
2. Comprueba el contrato en el CI del productor
Cada vez que el equipo de la aplicación abre un cambio, su pipeline de integración continua compara el esquema resultante con el contrato. Si el cambio lo rompe, el despliegue se detiene y el propio equipo recibe el aviso, con la lista de consumidores afectados. Es el mismo principio que las pruebas de software: detectar el problema donde nace, no donde duele.
3. Cambia por fases: expandir, migrar y contraer
Los cambios incompatibles a veces son necesarios. La forma de hacerlos sin interrumpir a nadie es en tres fases:
- Expandir: se añade la columna nueva,
client_id, sin quitar la antigua, y se rellenan ambas. - Migrar: los consumidores pasan a usar la nueva, con un plazo acordado y visible.
- Contraer: cuando ningún consumidor usa la antigua, se elimina.
4. Versiona cuando no haya otra salida
Si el cambio es tan profundo que no admite convivencia, se publica una versión nueva del dato o del evento en paralelo, y la anterior se mantiene durante un periodo de transición anunciado.
5. Vigila lo que se escape
Ningún contrato cubre todo. Una capa de observabilidad de datos detecta desvíos de esquema, caídas de volumen, retrasos y valores fuera de lo esperado, y avisa al dueño del dato antes de que lo haga un usuario. Las pruebas de datos en el propio pipeline, como los tests de dbt, son la primera línea de esa vigilancia.
Quién es responsable de qué
Los contratos funcionan cuando las responsabilidades están claras:
- El equipo que produce el dato es dueño del contrato: lo mantiene, respeta su política de cambios y avisa con antelación de lo incompatible.
- El equipo de plataforma automatiza la comprobación en CI, registra los contratos en el catálogo y mantiene el linaje de extremo a extremo para saber quién consume cada dato.
- Los equipos que consumen declaran de qué dependen y prueban sus transformaciones contra el contrato, no contra lo que hoy hay en la tabla.
Saber quién consume cada dato es lo que convierte un cambio en una decisión informada. Sin ese mapa, cualquier equipo de producto trabaja a ciegas.
El coste oculto de no hacerlo
Sin contratos, el mantenimiento de la plataforma se convierte en una sucesión de incidencias reactivas. El equipo de datos dedica una parte creciente de su tiempo a reparar lo que otros cambian, en lugar de construir lo que el negocio le pide. Y cada incidencia erosiona algo más difícil de recuperar que las horas perdidas: la confianza del negocio en sus cifras. Cuando un director deja de fiarse de un dashboard, vuelve a su hoja de cálculo, y la inversión en la plataforma pierde buena parte de su sentido.
¿Cada despliegue de tus aplicaciones es una lotería para tus dashboards?
En Galde diseñamos plataformas de datos en las que los cambios en origen se detectan antes de desplegarse, con interfaces estables, contratos comprobados en CI y observabilidad que avisa al dueño correcto, para que el mantenimiento deje de ser una sucesión de incendios.
Cómo puede ayudar Galde a blindar tus pipelines frente a los cambios
Desde data platforms, separamos las interfaces de datos de los esquemas internos de las aplicaciones, automatizamos la comprobación de contratos en el CI de los equipos de producto y desplegamos la observabilidad que detecta lo que se escapa.
Desde gobernanza de datos, definimos quién es dueño de cada dato, qué política de cambios aplica y cómo se registra cada contrato en el catálogo, para que las reglas no dependan de la memoria de nadie.
Y desde la IA generativa, aplicamos la misma disciplina a los datos que alimentan tus asistentes y agentes, que necesitan fuentes estables para seguir funcionando: es la diferencia entre un Data Product y un Data Project.
Conclusión
Los cambios en las aplicaciones no se van a detener, ni deben hacerlo: son la señal de que el producto evoluciona. Lo que sí puede evitarse es que cada cambio llegue por sorpresa a la analítica. Con una interfaz estable, un contrato comprobado automáticamente y cambios hechos por fases, los equipos de producto ganan libertad para mejorar y los equipos de datos dejan de apagar incendios.
Preguntas frecuentes
¿Qué es un contrato de datos?
Es un acuerdo explícito y versionado entre quien produce un dato y quien lo consume. Define el esquema, el significado de cada campo, las garantías de calidad y frescura, el dueño y la política de cambios, y se escribe como código para poder comprobarlo automáticamente.
¿Los contratos de datos frenan al equipo de desarrollo?
No, si se aplican bien. Los cambios compatibles pasan sin fricción y solo se detienen los que romperían a otros equipos. Detectarlos en el CI es mucho más barato que repararlos en producción.
¿Qué diferencia hay entre un contrato de datos y un esquema?
El esquema describe la forma de los datos. El contrato añade el significado, las garantías de calidad y frescura, el dueño y cómo se gestionan los cambios. Un esquema puede ser técnicamente idéntico y, aun así, romper el contrato si cambia el significado de un campo.
¿Es suficiente con la captura de cambios (CDC) para evitar roturas?
No. El CDC replica fielmente los cambios, también los de estructura, así que traslada las roturas más rápido. Funciona bien cuando se aplica sobre una interfaz estable, como una tabla de salida, y no sobre las tablas internas de la aplicación.
¿Por dónde empezar si no tenemos ningún contrato?
Por los tres o cuatro datos que alimentan los informes más críticos. Identifica quién los produce, publica una interfaz estable, escribe su contrato y añade la comprobación al CI del productor. Con eso se elimina la mayor parte de las incidencias que más duelen.