Linaje de datos en entornos multi-cloud: el reto de la trazabilidad absoluta

Capturar el linaje en tiempo de ejecución, con un estándar abierto, para seguir cada dato desde su origen en AWS o Azure hasta el informe de negocio
Respuesta rápida:
El linaje de datos es el registro del camino que recorre un dato: de qué fuentes sale, qué transformaciones lo modifican y en qué informes acaba. En un entorno multi-cloud, cada nube y cada herramienta tienen su propio catálogo con un linaje parcial, y el camino completo se rompe en las fronteras entre ellas.
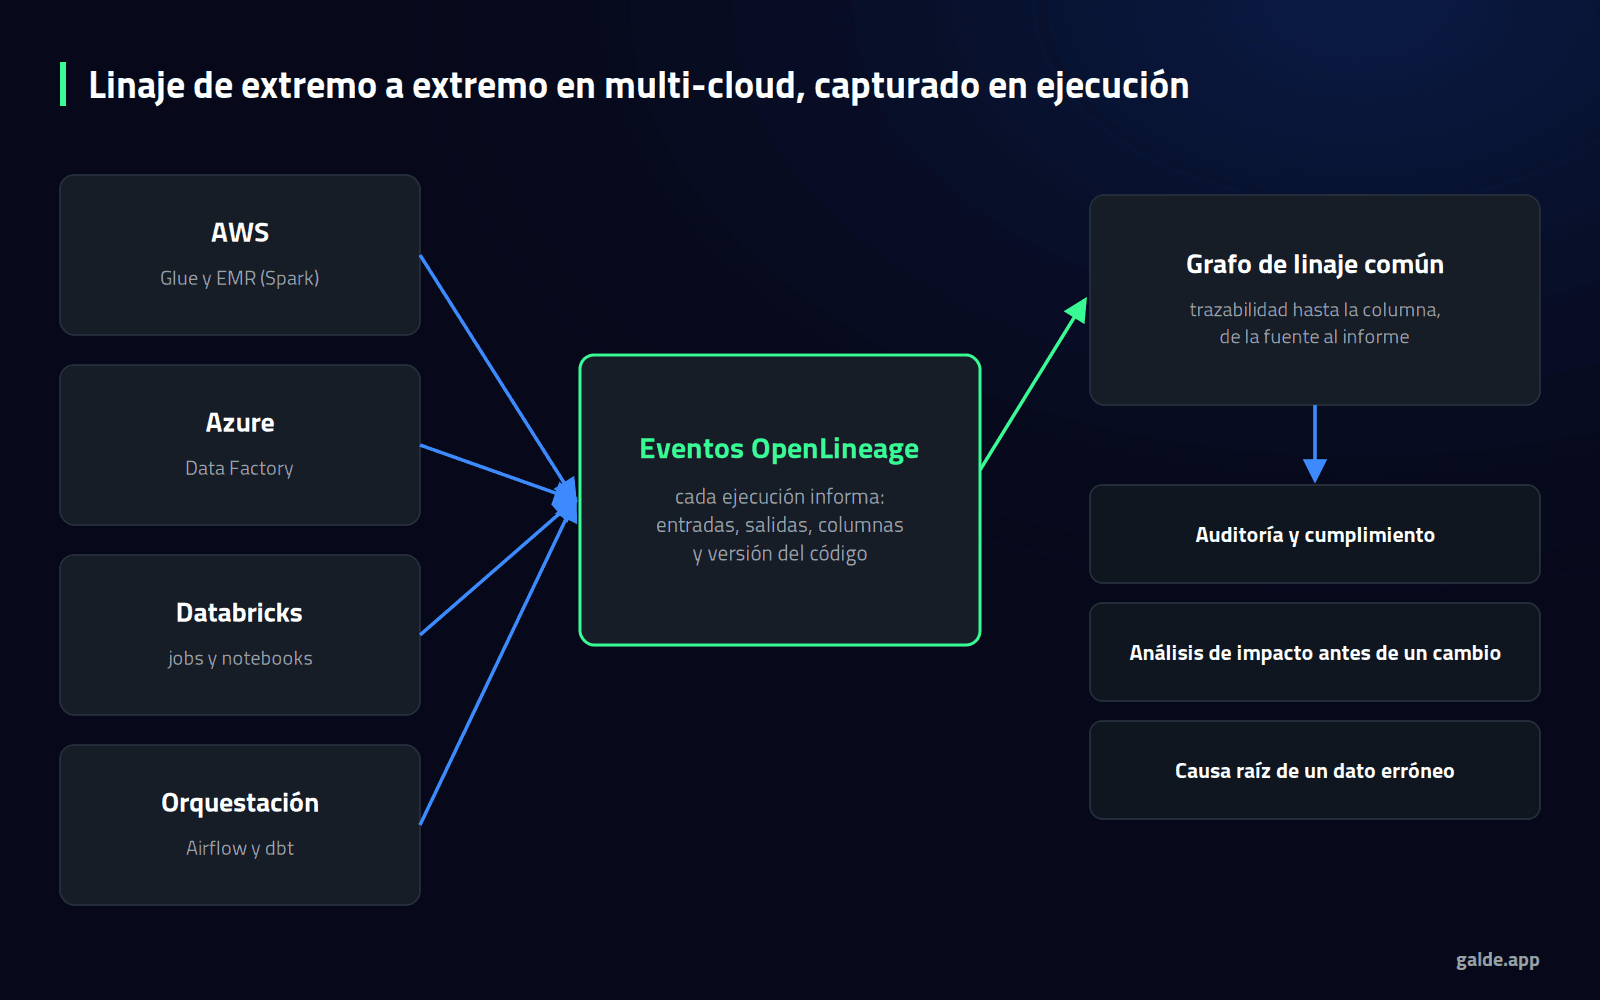
La solución es capturar el linaje automáticamente en tiempo de ejecución: cada proceso informa, al ejecutarse, de qué datos ha leído y cuáles ha escrito. Usando un estándar abierto como OpenLineage y un criterio común para nombrar los conjuntos de datos en todas las nubes, esos eventos se consolidan en un grafo único de extremo a extremo.
Así, la trazabilidad deja de depender de documentación manual y se vuelve fiable para auditorías, análisis de impacto y control de calidad.
El linaje que se documenta a mano describe cómo se diseñó el pipeline. El que se captura en ejecución describe lo que de verdad pasó.
Un auditor pregunta de dónde sale una cifra concreta de un informe regulatorio. La respuesta exige reconstruir un recorrido que empieza en un sistema operacional en AWS, pasa por un proceso de Spark, se transforma en Databricks, se agrega en Snowflake y termina en un informe de Power BI. Hay que reunir a tres equipos, revisar documentación desactualizada y, al cabo de una semana, la respuesta llega con varios «creemos que».
Cada herramienta, por separado, sabía una parte del camino. Ninguna sabía el camino completo.
En multi-cloud, el linaje no se pierde dentro de cada herramienta. Se pierde en las fronteras entre ellas.
Por qué el linaje se rompe en entornos multi-cloud
Los catálogos nativos de cada plataforma, como AWS Glue Data Catalog, Microsoft Purview, Unity Catalog o Google Dataplex, capturan bien el linaje de lo que ocurre dentro de su ámbito. Los problemas aparecen en los traspasos:
- Cada catálogo ve solo su parte: el linaje de Unity Catalog termina donde el dato sale hacia Snowflake, y el de Snowflake empieza sin saber de dónde venía.
- Nombres incoherentes: el mismo conjunto de datos se llama de una forma en el almacenamiento, de otra en el catálogo y de otra en el informe, y nadie puede unir los tramos.
- Documentación manual: los diagramas de linaje dibujados a mano se desactualizan con el primer cambio en producción.
- Procesos fuera del radar: scripts ejecutados directamente contra una base de datos o una hoja de cálculo intermedia rompen la cadena sin dejar rastro.
Linaje estático frente a linaje en tiempo de ejecución
Hay dos formas de obtener el linaje. El linaje estático se deduce analizando el código o el SQL de los procesos: describe lo que el pipeline haría. El linaje en tiempo de ejecución se captura cuando el proceso se ejecuta: registra qué datos se leyeron y escribieron realmente, en qué ejecución, con qué versión del código y con qué resultado.
El linaje estático es útil para anticipar el impacto de un cambio antes de desplegarlo. Pero para una auditoría o para investigar un dato erróneo, la pregunta es qué pasó de verdad, y eso solo lo responde el linaje en tiempo de ejecución. Lo razonable es combinar ambos, con el de ejecución como fuente de verdad.
OpenLineage: un estándar abierto para capturar el linaje en ejecución
OpenLineage es un estándar abierto, alojado en la LF AI & Data Foundation, que define cómo describir cada ejecución de un proceso: un evento con el trabajo que se ejecuta, la ejecución concreta, los conjuntos de datos de entrada y salida, y unas facetas opcionales con el esquema, el linaje por columna, métricas de calidad o la ubicación del código.
Su gran ventaja en multi-cloud es que no pertenece a ninguna nube. Existen integraciones para Apache Spark, Apache Airflow, dbt o Apache Flink, que emiten los eventos sin cambiar el código de los procesos; Marquez es su implementación de referencia para almacenarlos, y varios servicios de las propias nubes, como el linaje de Dataplex en Google Cloud o Amazon DataZone, ya aceptan eventos OpenLineage.
Un evento, simplificado, tiene este aspecto:
{
  "eventType": "COMPLETE",
  "eventTime": "2026-09-22T06:12:03Z",
  "run": { "runId": "3f1c2a90-5b7e-4d21-9c3a-8e2f1b6d7a44" },
  "job": { "namespace": "databricks-prod", "name": "ventas.pedidos_diarios" },
  "inputs": [{ "namespace": "s3://datos-crudos", "name": "erp/pedidos" }],
  "outputs": [{ "namespace": "snowflake://acme-eu", "name": "ANALITICA.VENTAS.PEDIDOS_DIARIOS" }]
}
Cómo diseñar una arquitectura de linaje multi-cloud
1. Acordar cómo se nombra cada conjunto de datos en todas las nubes
Es el paso menos vistoso y el más importante. Si el mismo dato recibe nombres distintos en cada tramo, los eventos no se pueden unir. OpenLineage propone convenciones de nombre por tipo de almacenamiento, como la ruta del bucket en S3 o la cuenta, la base de datos y el esquema en Snowflake, que conviene adoptar sin excepciones.
2. Instrumentar los motores de ejecución, no a las personas
El linaje fiable no lo escribe nadie: lo emiten los motores. Se activan las integraciones de Spark, Airflow y dbt, y para el SQL que se ejecuta directamente en los data warehouses se aprovecha su propio historial de accesos, como la vista ACCESS_HISTORY de Snowflake, que registra qué objetos y columnas leyó y escribió cada consulta.
3. Consolidar los eventos en un grafo común
Los eventos de todas las nubes se envían a un único backend de linaje, sea Marquez o el catálogo corporativo que actúe como punto común. Allí se une el camino completo, de la fuente al informe, y se expone a los dueños de los datos y a los equipos de cumplimiento.
4. Bajar al nivel de columna donde importe
No todo necesita linaje por columna. Pero para las métricas reguladas, los indicadores financieros y los datos personales, saber qué columna de origen alimenta cada campo de un informe es lo que convierte el linaje en una evidencia de auditoría.
5. Conectar el linaje con la calidad y los contratos
El linaje aporta todo su valor cuando se cruza con los resultados de calidad: permite encontrar la causa raíz de un dato erróneo y hacer análisis de impacto antes de un cambio, avisando a quien depende de él. Es la base para que los contratos de datos sepan a quién proteger.
Qué exigen las auditorías y cómo ayuda el linaje
Cada vez más normativas piden demostrar de dónde sale un dato, no solo afirmarlo. En banca, los principios BCBS 239 exigen trazabilidad en la agregación de los datos de riesgo. El Reglamento General de Protección de Datos obliga a saber qué tratamientos se hacen con los datos personales y por dónde circulan. Y el Reglamento Europeo de Inteligencia Artificial pide documentar el origen y el tratamiento de los datos en los sistemas de alto riesgo.
En todos los casos, un linaje capturado en ejecución, conservado y consultable responde en minutos lo que una reconstrucción manual responde en semanas, y con una evidencia verificable en lugar de una estimación. Para el detalle de cómo automatizar los metadatos con Unity Catalog y los servicios de AWS, puedes consultar nuestra arquitectura de gobierno para pipelines de datos multi-cloud.
¿Podrías demostrar hoy de dónde sale cada cifra de tus informes críticos?
En Galde diseñamos arquitecturas de linaje de extremo a extremo para infraestructuras multi-cloud complejas: capturado en ejecución, con estándares abiertos y conectado con la calidad y el catálogo, para que la trazabilidad resista cualquier auditoría.
Cómo puede ayudar Galde a garantizar la trazabilidad de tus datos
Desde gobernanza de datos, definimos qué necesita trazabilidad por columna, cómo se nombran los conjuntos de datos en todas las nubes y qué evidencias necesitan tus auditorías, con criterios que ya aplicamos al elegir herramientas de gobierno del dato.
Desde data platforms, instrumentamos los motores de ejecución de AWS, Azure y Databricks con OpenLineage, consolidamos los eventos en un grafo común y los conectamos con las pruebas de calidad.
Y desde la IA generativa, extendemos la trazabilidad a los datos que alimentan tus modelos y asistentes, una exigencia cada vez más habitual para los sistemas de IA.
Conclusión
En multi-cloud, la trazabilidad absoluta no se consigue eligiendo el mejor catálogo, sino evitando que el linaje dependa de un solo catálogo. Capturar cada ejecución con un estándar abierto, nombrar los datos igual en todas las nubes y consolidarlo todo en un grafo común convierte el linaje en lo que las auditorías y los equipos de calidad necesitan: la historia verificable de cada dato.
Preguntas frecuentes
¿Qué es el linaje de datos?
Es el registro del camino que recorre un dato: de qué fuentes sale, qué transformaciones lo modifican y en qué informes o modelos acaba. Permite responder de dónde viene una cifra y qué se vería afectado si cambia.
¿Qué diferencia hay entre el linaje estático y el linaje en tiempo de ejecución?
El estático se deduce del código y describe lo que el proceso haría. El de ejecución se captura cuando el proceso corre y registra lo que realmente leyó y escribió. Para auditorías e investigación de errores, el de ejecución es la fuente de verdad.
¿Qué es OpenLineage?
Es un estándar abierto que define cómo describir cada ejecución de un proceso, con sus datos de entrada y salida, en un formato independiente de cualquier nube o herramienta. Tiene integraciones para motores como Spark, Airflow y dbt.
¿Basta con el linaje de Unity Catalog o de AWS Glue?
Dentro de su ámbito, capturan bien el linaje. El problema aparece cuando el dato cruza entre plataformas o nubes, donde cada catálogo pierde el rastro. Un estándar común y un criterio de nombres compartido permiten unir los tramos.
¿Hace falta linaje por columna para todos los datos?
No. Es costoso y no siempre aporta valor. Conviene aplicarlo a las métricas reguladas, los indicadores financieros y los datos personales, donde la trazabilidad por columna es la evidencia que piden las auditorías.