De MVP a producto: por qué la IA generativa necesita un Data Product

Lo que se rompe cuando un piloto de RAG que funcionaba pasa a producción, y cómo reorganizar sus datos para que siga funcionando
Respuesta rápida:
Los pilotos de IA generativa y de RAG suelen funcionar sobre una copia estática de los datos, seleccionada y limpiada a mano para la demostración. En producción fallan por lo que no se ve en la demo: los documentos cambian y el índice no, los borrados no llegan, los permisos del origen no se respetan, nadie mide la calidad de las respuestas y nadie es responsable de mantener las fuentes.
Para sostener una aplicación de IA a largo plazo, sus fuentes de datos deben gestionarse como un Data Product: con actualización continua, un dueño claro con un compromiso de frescura, calidad medida de forma sistemática, permisos heredados del origen y un índice versionado.
No es un problema del modelo, sino de cómo se gestionan los datos que lo alimentan. Y por eso se resuelve reestructurando esos datos, no cambiando de modelo.
El piloto demostró que la IA podía responder bien. Producción exige que siga respondiendo bien cuando los datos cambien.
La historia se repite en muchas empresas. En seis semanas, un equipo construye un asistente que responde preguntas sobre la normativa interna, los procedimientos o el catálogo de productos. La demostración impresiona y la dirección decide desplegarlo para toda la plantilla. Tres meses después, el asistente cita una política que se actualizó en primavera, un empleado recibe fragmentos de un documento de otro departamento que no debería ver, el coste mensual ha crecido y, cuando algo falla, nadie sabe a quién le corresponde arreglarlo.
El modelo es el mismo que brilló en la demostración. Lo que ha cambiado es todo lo que lo rodea.
Un MVP de IA generativa prueba una hipótesis. Un producto tiene que sostener una promesa.
Por qué tantos pilotos de IA generativa no llegan a producción
Un piloto está diseñado para responder una pregunta: ¿puede la IA generativa resolver este caso de uso? Para contestarla rápido, se toman atajos razonables: se exporta una vez el conjunto de documentos, se limpia a mano, se indexa y se evalúa con unas cuantas preguntas de prueba. Esos atajos son correctos para un experimento. El problema aparece cuando el experimento se convierte, sin más, en el sistema que usará toda la empresa.
Ya analizamos los errores más comunes al implementar IA generativa en empresas y qué hace falta para llevarla a producción. En la mayoría de los casos, el punto de rotura no está en el modelo, sino en los datos.
Qué se rompe al pasar un piloto de RAG a producción
Los datos envejecen y el índice no
El índice se construyó con una fotografía de los documentos. Cada política actualizada, cada producto nuevo y cada procedimiento revisado lo hacen un poco más obsoleto, y el sistema sigue respondiendo con seguridad a partir de información caducada.
Los borrados nunca llegan al índice
Incluso cuando se añade una carga periódica de documentos nuevos, es habitual olvidar los borrados. Un documento retirado del origen sigue en el índice y sigue apareciendo en las respuestas, a veces durante meses.
Los permisos del origen no se respetan
En el piloto, todos los usuarios eran del mismo equipo y podían ver todo. En producción, cada documento tiene sus permisos en el sistema de origen, y si el índice no los hereda, el asistente se convierte en una puerta trasera a información restringida. Es uno de los riesgos que tratamos al hablar de seguridad y soberanía en arquitecturas RAG.
Nadie mide la calidad de las respuestas
El piloto se evaluó con unas pocas preguntas y el visto bueno de los usuarios de prueba. En producción no hay un conjunto de evaluación estable ni métricas que avisen si la calidad cae después de un cambio en las fuentes o en el sistema.
Nadie es dueño de las fuentes
El equipo que construyó el piloto suele ser el de IA, que no es el dueño natural de los documentos de Recursos Humanos, de Legal o de Soporte. Cuando una fuente se degrada, no hay nadie con la responsabilidad formal de corregirla.
Cualquier cambio obliga a empezar de cero
Cambiar el modelo de embeddings, la forma de dividir los documentos o la estructura del índice obliga a reindexarlo todo. Sin versiones, ese cambio se hace sobre el índice en uso, y las respuestas cambian de un día para otro sin que nadie pueda compararlas ni volver atrás.
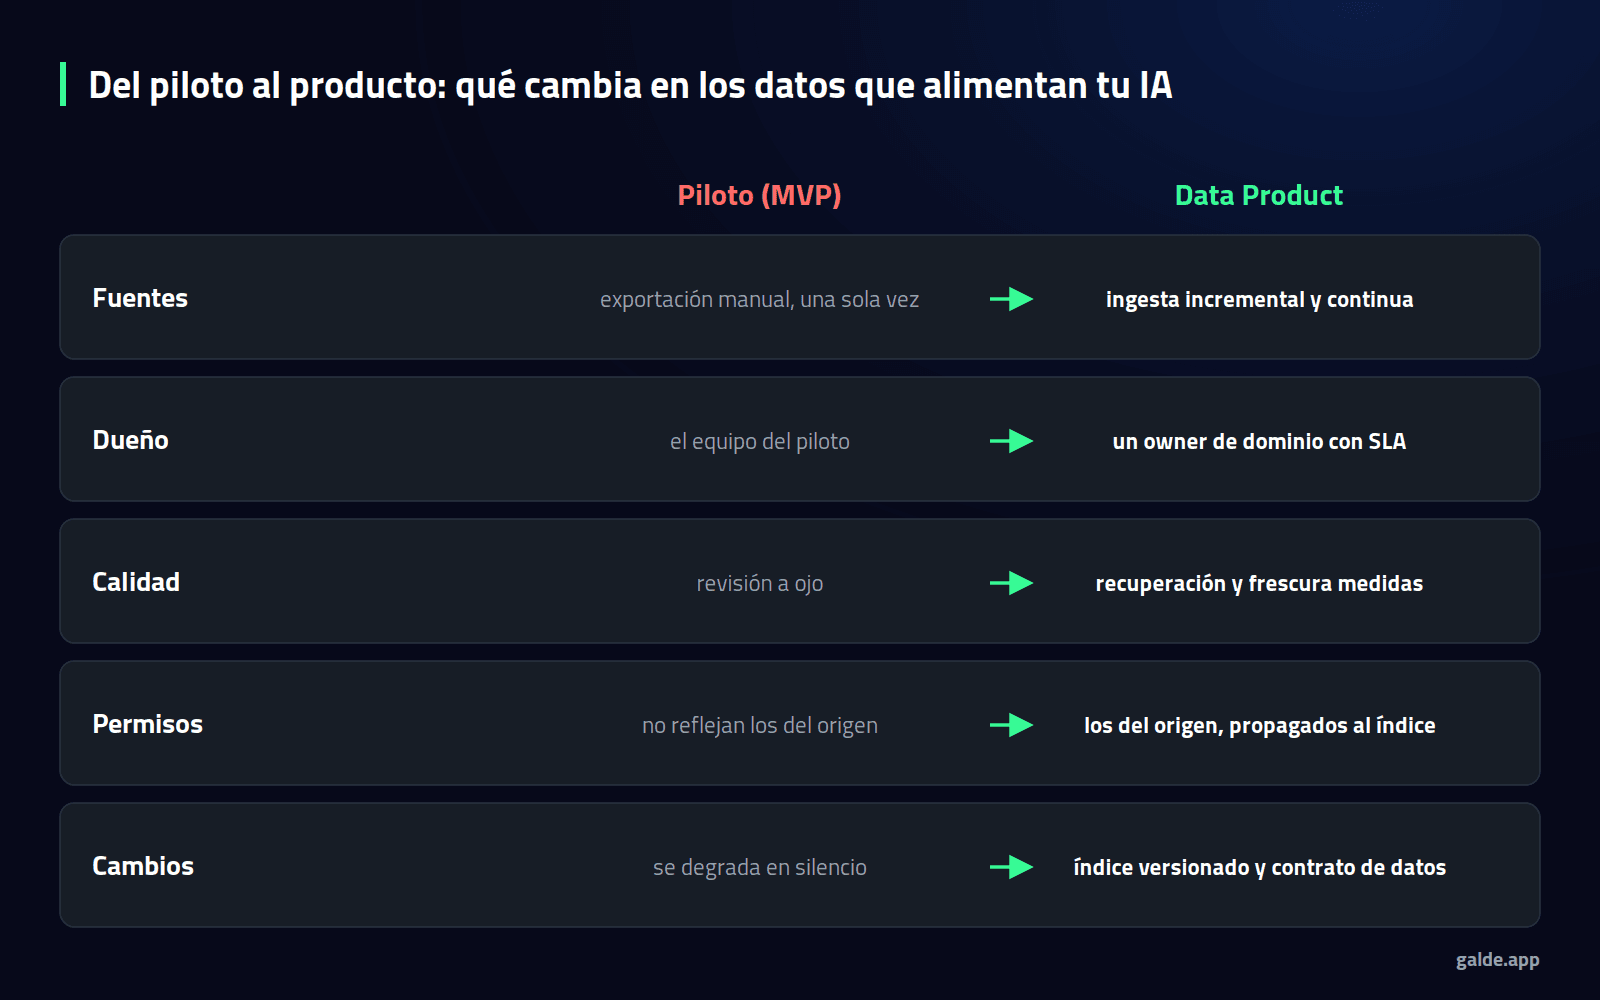
Qué significa gestionar las fuentes de tu IA como un Data Product
Ya explicamos en detalle la diferencia entre un Data Product y un Data Project. Aplicada a la IA generativa, se traduce en cinco propiedades concretas:
- Actualización continua: la ingesta es incremental y detecta altas, cambios y borrados en el origen, con un retraso máximo acordado entre un cambio y su reflejo en el índice.
- Un dueño con un compromiso de servicio: cada fuente de conocimiento tiene un responsable en su dominio de negocio, que garantiza su frescura y su exactitud, no el equipo de IA.
- Calidad medida: hay un conjunto de preguntas de evaluación representativo y métricas que se calculan con cada cambio, como la tasa de recuperación del fragmento correcto, la fidelidad de las respuestas a las fuentes y el retraso de actualización.
- Permisos heredados del origen: cada fragmento indexado conserva los permisos de su documento, y el sistema filtra lo que recupera según quién pregunta.
- Índice versionado: los cambios de modelo, de fragmentación o de estructura se construyen en una versión nueva del índice, se evalúan contra la anterior y solo sustituyen a la vigente si la mejoran.
Nada de esto requiere un modelo distinto. Requiere tratar los datos que alimentan la IA con la misma disciplina que cualquier producto que usa toda la empresa.
Cómo pasar del piloto al producto en 60 días
Es el mismo enfoque de nuestra metodología: un producto de datos listo para producción en 60 días, con un sponsor técnico que dedique dos horas semanales.
Días 1 a 15: inventario de fuentes y dueños
Se identifican las fuentes que alimentan el piloto, su sistema de origen, su frecuencia real de cambio y sus permisos, y se asigna un dueño a cada una en su dominio de negocio.
Días 16 a 30: ingesta incremental y permisos
Se sustituye la exportación manual por una ingesta incremental que detecta altas, cambios y borrados, y se incorporan los permisos del origen a cada fragmento indexado.
Días 31 a 45: medir la calidad
Se construye con los usuarios un conjunto de evaluación representativo y se automatizan las métricas de recuperación, fidelidad y frescura, para que cualquier cambio se pueda comparar con la situación anterior.
Días 46 a 60: versionar y operar
Se introduce el índice versionado, las alertas sobre frescura y calidad, y el procedimiento para que cada dueño corrija su fuente. A partir de aquí, el sistema se opera como un producto.
¿Está tu IA generativa lista para producción?
Cinco preguntas bastan para saberlo:
- Si un documento cambia hoy, ¿cuánto tarda el asistente en reflejarlo, y lo sabes medir?
- Si un documento se retira del origen, ¿desaparece también de las respuestas?
- ¿Recibe cada usuario solo información que podría ver en el sistema de origen?
- Si mañana cambias el modelo de embeddings, ¿puedes comparar las respuestas antes y después?
- Si una fuente se degrada, ¿hay una persona con la responsabilidad formal de corregirla?
Si alguna respuesta es no, el sistema sigue siendo un piloto, aunque lo use toda la empresa.
¿Tu piloto de IA generativa funcionó en la demo y se atasca al llevarlo a producción?
En Galde reestructuramos los datos que alimentan tus aplicaciones de IA generativa para que dejen de ser una fotografía del piloto y se conviertan en Data Products: actualizados, con dueño, con permisos y con una calidad que se mide. Es lo que convierte un piloto prometedor en un sistema que aporta valor de negocio de verdad.
Cómo puede ayudar Galde a llevar tu IA generativa a producción
Desde la IA generativa, rediseñamos la arquitectura del sistema RAG para producción: ingesta incremental, permisos heredados, índice versionado y evaluación continua. Es también la base para dar el siguiente paso hacia el RAG basado en agentes.
Desde gobernanza de datos, asignamos un dueño a cada fuente de conocimiento, definimos sus compromisos de frescura y calidad y los registramos en el catálogo.
Y desde data platforms, construimos los pipelines, la monitorización y las alertas que sostienen esos compromisos sin intervención manual.
Conclusión
La mayoría de los pilotos de IA generativa no fracasan porque el modelo sea insuficiente, sino porque sus datos siguen gestionándose como los de un experimento. Pasar de MVP a producto exige que las fuentes se actualicen solas, respeten los permisos, tengan un dueño y se midan de forma continua. Con eso, la IA deja de ser una demostración que envejece y se convierte en un sistema que mejora con el tiempo.
Preguntas frecuentes
¿Por qué un piloto de RAG funciona bien y después empeora en producción?
Porque el piloto usa una copia estática de los datos, preparada a mano. En producción los documentos cambian, se retiran o cambian de permisos, y si el índice no se actualiza de forma continua, las respuestas se basan cada vez más en información caducada.
¿Qué es un Data Product aplicado a la IA generativa?
Es una fuente de datos gestionada como un producto: con actualización continua, un dueño responsable de su frescura y exactitud, calidad medida, permisos heredados del origen y versiones controladas. Es lo que permite sostener una aplicación de IA a largo plazo.
¿Hay que cambiar de modelo para pasar a producción?
Normalmente no. La mayoría de los problemas de producción están en los datos que alimentan al modelo, no en el modelo. Cambiar de modelo sin arreglar los datos suele reproducir los mismos fallos.
¿Cómo se mide la calidad de un sistema RAG?
Con un conjunto de preguntas de evaluación representativo y métricas que se calculan con cada cambio: si el sistema recupera los fragmentos correctos, si las respuestas son fieles a las fuentes y cuánto tarda un cambio del origen en reflejarse en el índice.
¿Quién debe ser el dueño de las fuentes de una aplicación de IA?
El dominio de negocio que genera o gestiona cada fuente, como Recursos Humanos para las políticas internas o Soporte para la base de conocimiento, y no el equipo que construye la IA, que rara vez puede garantizar su exactitud.